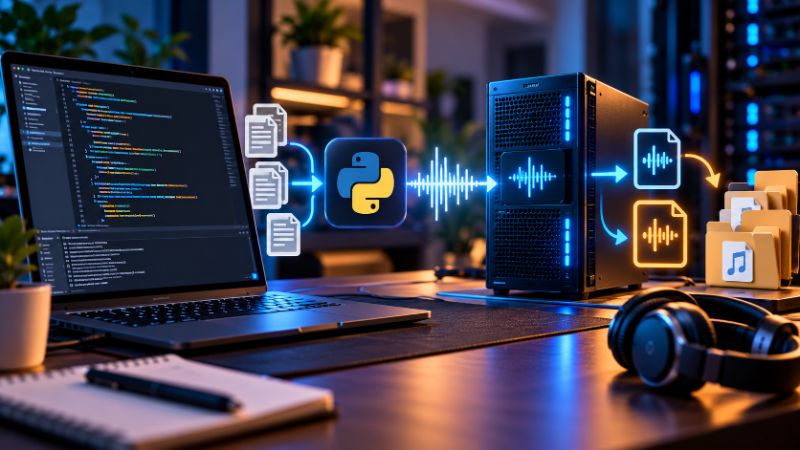
Piper TTS eignet sich nicht nur für die manuelle Umwandlung einzelner Texte in Sprache. In Kombination mit Python lässt sich die lokale Sprachsynthese umfassend automatisieren. Von der einfachen Erzeugung einer WAV-Datei über die Verarbeitung ganzer Textsammlungen bis hin zu Warteschlangen, Fehlerbehandlung und automatisierten Audio-Workflows eröffnen sich zahlreiche Möglichkeiten.
Im vorherigen Teil unserer Blogserie haben wir Piper TTS über eine REST-API als zentralen Sprachdienst bereitgestellt. Nun beschäftigen wir uns mit der direkten Automatisierung über Python. Dabei können wir Piper entweder unmittelbar über seine Python-Schnittstelle oder über eine bereits vorhandene REST-API ansprechen.
Das Ziel: Eine flexible, vollständig lokale Automatisierungslösung entwickeln, die Texte selbstständig verarbeitet, Audiodateien erzeugt, organisiert und für andere Anwendungen bereitstellt.
Besonders interessant ist dieser Ansatz für die automatische Vertonung von Blogartikeln, Podcasts, KI-Antworten, Benachrichtigungen und größeren Textsammlungen.
1. Warum Piper TTS mit Python automatisieren?
Bei einer einzelnen Sprachausgabe genügt häufig ein einfacher Kommandozeilenaufruf. Sobald jedoch regelmäßig Texte verarbeitet oder zahlreiche Audiodateien erzeugt werden sollen, stößt die manuelle Vorgehensweise an ihre Grenzen.
Python bietet hierfür eine leistungsfähige und gleichzeitig gut verständliche Grundlage.
Mit Python können wir Texte aus Dateien einlesen, automatisch aufbereiten, an Piper übergeben und die erzeugten Audiodateien strukturiert speichern.
Darüber hinaus lassen sich zusätzliche Funktionen integrieren, beispielsweise eine automatische Dateibenennung, Protokollierung, Fehlerbehandlung oder Konvertierung in andere Audioformate.
Typische Einsatzmöglichkeiten sind:
- Automatische Vertonung neuer Blogartikel
- Erstellung von Audioversionen technischer Dokumentationen
- Generierung von Sprachnachrichten aus Monitoring-Systemen
- Batch-Verarbeitung größerer Textsammlungen
- Automatisierte Podcast-Produktion
- Sprachsynthese für lokale KI-Assistenten
- Erstellung mehrsprachiger Audioinhalte
- Verarbeitung von Texten aus Datenbanken und Webanwendungen
Ein wesentlicher Vorteil ist die vollständige Kontrolle über den Verarbeitungsprozess.
Die Texte müssen nicht an einen externen Cloud-Dienst übertragen werden. Die gesamte Sprachsynthese kann innerhalb der eigenen Infrastruktur stattfinden.
2. Voraussetzungen für die Python-Automatisierung
Für unsere Beispiele verwenden wir einen Linux-Server mit Debian oder Ubuntu.
Benötigt werden Python, eine funktionierende Piper-Installation und mindestens ein passendes Sprachmodell.
Wir gehen davon aus, dass Piper bereits aus den vorherigen Teilen der Serie bekannt ist.
Zunächst installieren wir die benötigten Systempakete.
sudo apt update

sudo apt install -y \
  python3 \
  python3-venv \
  python3-pip \
  ffmpeg
Anschließend erstellen wir ein Projektverzeichnis.
mkdir -p ~/piper-automation

cd ~/piper-automation
Nun richten wir eine virtuelle Python-Umgebung ein.
python3 -m venv venv
Diese aktivieren wir:
source venv/bin/activate
Jetzt installieren wir Piper und weitere benötigte Python-Pakete.
python -m pip install --upgrade pip

python -m pip install \
  piper-tts \
  requests
Das Paket piper-tts ermöglicht den direkten Zugriff auf die Piper-Sprachsynthese. requests benötigen wir später für die Kommunikation mit einer REST-API.
Für unsere Automatisierung legen wir eine übersichtliche Verzeichnisstruktur an.
piper-automation/
├── venv/
├── models/
├── input/
├── output/
├── archive/
├── failed/
├── logs/
└── scripts/
Die Verzeichnisse erstellen wir mit:
mkdir -p \
  models \
  input \
  output \
  archive \
  failed \
  logs \
  scripts
Damit haben wir eine Grundlage für die weiteren Beispiele geschaffen.
3. Ein deutsches Sprachmodell einrichten
Für die Sprachsynthese benötigen wir ein Piper-Modell.
In unseren Beispielen verwenden wir das deutsche Modell de_DE-thorsten-medium.
Die beiden erforderlichen Dateien werden im Verzeichnis models abgelegt:
models/
├── de_DE-thorsten-medium.onnx
└── de_DE-thorsten-medium.onnx.json
Sofern das installierte Piper-Paket das Kommando python -m piper.download_voices bereitstellt, lässt sich das Modell beispielsweise folgendermaßen herunterladen:
python -m piper.download_voices \
  --data-dir models \
  de_DE-thorsten-medium
Die genaue Verfügbarkeit dieses Befehls hängt von der verwendeten Piper-Version ab. Alternativ können die Modelldateien aus dem offiziellen Piper-Stimmenrepository heruntergeladen werden.
Anschließend überprüfen wir die Dateien:
ls -lh models/
Wichtig ist, dass die ONNX-Datei und ihre JSON-Konfiguration zusammengehören.
Hinweis: Die folgenden Python-Beispiele orientieren sich an der Piper-Schnittstelle mit PiperVoice.load() und synthesize_wav(). Bei anderen Paketversionen können sich einzelne Methoden unterscheiden. Für reproduzierbare Automatisierungen sollten die getesteten Paketversionen festgehalten werden.
4. Erste Sprachdatei mit Python erzeugen
Wir beginnen mit einem einfachen Python-Skript, das einen Text in eine WAV-Datei umwandelt.
Dazu erstellen wir die Datei:
nano scripts/tts_simple.py
Der Inhalt:
from pathlib import Path
import wave

from piper import PiperVoice

BASE_DIR = Path(__file__).resolve().parent.parent

MODEL_PATH = (
    BASE_DIR
    / "models"
    / "de_DE-thorsten-medium.onnx"
)

OUTPUT_PATH = BASE_DIR / "output" / "hallo.wav"

TEXT = """
Hallo und willkommen bei Piper TTS.
Diese Audiodatei wurde automatisch
mit Python erzeugt.
"""

OUTPUT_PATH.parent.mkdir(
    parents=True,
    exist_ok=True
)

voice = PiperVoice.load(str(MODEL_PATH))

with wave.open(str(OUTPUT_PATH), "wb") as wav_file:
    voice.synthesize_wav(TEXT, wav_file)

print(f"Audiodatei erstellt: {OUTPUT_PATH}")
Das Skript lädt zunächst das Sprachmodell.
Anschließend wird der definierte Text an Piper übergeben und die erzeugte Sprachausgabe als WAV-Datei gespeichert.
Wir starten das Skript mit:
python scripts/tts_simple.py
Nach erfolgreicher Verarbeitung befindet sich die Audiodatei im Verzeichnis:
output/hallo.wav
Damit haben wir bereits die Grundlage für die weitere Automatisierung geschaffen.
5. Texte aus Dateien automatisch einlesen
In der Praxis werden Texte häufig nicht direkt im Python-Code hinterlegt.
Stattdessen stammen sie aus Textdateien, Datenbanken, Webanwendungen oder anderen automatisierten Prozessen.
Wir erweitern unser Beispiel deshalb um das Einlesen einer Textdatei.
Zunächst erstellen wir eine Beispieldatei.
nano input/artikel.txt
Beispielinhalt:
Willkommen zu unserem heutigen Technikbeitrag.

In diesem Artikel beschäftigen wir uns
mit der automatisierten Sprachsynthese.

Piper TTS ermöglicht die lokale Umwandlung
von Texten in natürlich klingende Sprache.
Nun erstellen wir ein Python-Skript.
nano scripts/tts_from_file.py
from pathlib import Path
import wave

from piper import PiperVoice

BASE_DIR = Path(__file__).resolve().parent.parent

MODEL_PATH = (
    BASE_DIR / "models" / "de_DE-thorsten-medium.onnx"
)

INPUT_FILE = BASE_DIR / "input" / "artikel.txt"
OUTPUT_FILE = BASE_DIR / "output" / "artikel.wav"

text = INPUT_FILE.read_text(
    encoding="utf-8"
).strip()

if not text:
    raise ValueError("Die Textdatei ist leer.")

voice = PiperVoice.load(str(MODEL_PATH))

OUTPUT_FILE.parent.mkdir(
    parents=True,
    exist_ok=True
)

with wave.open(str(OUTPUT_FILE), "wb") as wav_file:
    voice.synthesize_wav(text, wav_file)

print("Sprachdatei erfolgreich erstellt.")
Das Skript liest den Inhalt der Textdatei ein, überprüft, ob Text vorhanden ist, und übergibt diesen an Piper.
Auf diese Weise lassen sich Texte unabhängig vom eigentlichen Python-Programm verwalten.
Das ist insbesondere für die spätere Verarbeitung automatisch erzeugter Inhalte sinnvoll.
6. Batch-Verarbeitung: Mehrere Texte automatisch vertonen
Eine der interessantesten Möglichkeiten ist die Batch-Verarbeitung.
Dabei werden mehrere Textdateien automatisch nacheinander verarbeitet.
Stellen wir uns vor, im Verzeichnis input befinden sich zahlreiche Artikel.
input/
├── artikel01.txt
├── artikel02.txt
├── artikel03.txt
└── artikel04.txt
Jede Datei soll automatisch in eine gleichnamige WAV-Datei umgewandelt werden.
Dafür erstellen wir das Skript:
nano scripts/tts_batch.py
from pathlib import Path
import wave

from piper import PiperVoice

BASE_DIR = Path(__file__).resolve().parent.parent

INPUT_DIR = BASE_DIR / "input"
OUTPUT_DIR = BASE_DIR / "output"

MODEL_PATH = (
    BASE_DIR / "models" / "de_DE-thorsten-medium.onnx"
)

OUTPUT_DIR.mkdir(
    parents=True,
    exist_ok=True
)

voice = PiperVoice.load(str(MODEL_PATH))

files = sorted(INPUT_DIR.glob("*.txt"))

for input_file in files:

    print(f"Verarbeite: {input_file.name}")

    text = input_file.read_text(
        encoding="utf-8"
    ).strip()

    if not text:
        print("Datei ist leer. Überspringe.")
        continue

    output_file = (
        OUTPUT_DIR / f"{input_file.stem}.wav"
    )

    with wave.open(str(output_file), "wb") as wav_file:
        voice.synthesize_wav(text, wav_file)

    print(f"Erstellt: {output_file.name}")

print("Batch-Verarbeitung abgeschlossen.")
Wir starten die Verarbeitung:
python scripts/tts_batch.py
Piper verarbeitet nun sämtliche Textdateien nacheinander.
Ein großer Vorteil besteht darin, dass das Sprachmodell nur einmal geladen wird.
Das spart Initialisierungszeit und reduziert unnötige Systemlast.
Bei größeren Textsammlungen kann diese Vorgehensweise die Verarbeitung deutlich effizienter gestalten.
7. Dateinamen und Ausgabeverzeichnisse automatisch verwalten
Bei automatisierten Prozessen entstehen häufig viele Audiodateien.
Ohne eine geeignete Dateiverwaltung wird es schnell unübersichtlich.
Deshalb sollten Dateinamen möglichst eindeutig und nachvollziehbar sein.
Eine Möglichkeit ist die Verwendung von Zeitstempeln.
from datetime import datetime
from pathlib import Path

timestamp = datetime.now().strftime(
    "%Y%m%d_%H%M%S"
)

filename = f"speech_{timestamp}.wav"

output_file = Path("output") / filename
Das Ergebnis könnte folgendermaßen aussehen:
speech_20261020_143015.wav
Alternativ können wir Dateinamen aus dem ursprünglichen Text oder einer Artikel-ID ableiten.
Für größere Automatisierungen empfiehlt sich eine strukturierte Ablage nach Datum.
Beispielsweise:
output/
├── 2026/
│   └── 10/
│       ├── artikel01.wav
│       ├── artikel02.wav
│       └── artikel03.wav
Ein entsprechendes Verzeichnis lässt sich automatisch erzeugen:
from datetime import datetime
from pathlib import Path

now = datetime.now()

output_dir = (
    Path("output")
    / str(now.year)
    / f"{now.month:02d}"
)

output_dir.mkdir(
    parents=True,
    exist_ok=True
)
Gerade bei regelmäßig erzeugten Audiobeiträgen erleichtert diese Struktur die spätere Archivierung und Sicherung.
8. Fehlerbehandlung mit Python integrieren
Eine zuverlässige Automatisierung muss auch mit Fehlern umgehen können.
Mögliche Probleme sind beispielsweise fehlende Modelldateien, ungültige Texte, Berechtigungsfehler oder fehlender Speicherplatz.
Python bietet hierfür die try- und except-Anweisungen.
Wir erweitern unsere Verarbeitung um eine Fehlerbehandlung.
from pathlib import Path
import logging
import wave

from piper import PiperVoice

logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s %(levelname)s %(message)s"
)

MODEL_PATH = Path(
    "models/de_DE-thorsten-medium.onnx"
)

OUTPUT_FILE = Path("output/test.wav")

try:

    if not MODEL_PATH.exists():
        raise FileNotFoundError(
            f"Sprachmodell fehlt: {MODEL_PATH}"
        )

    voice = PiperVoice.load(str(MODEL_PATH))

    text = "Dies ist ein automatisierter Test."

    OUTPUT_FILE.parent.mkdir(
        parents=True,
        exist_ok=True
    )

    with wave.open(str(OUTPUT_FILE), "wb") as wav_file:
        voice.synthesize_wav(text, wav_file)

    logging.info(
        "Audiodatei erfolgreich erstellt."
    )

except FileNotFoundError as error:

    logging.error(
        "Dateifehler: %s",
        error
    )

except PermissionError as error:

    logging.error(
        "Berechtigungsfehler: %s",
        error
    )

except Exception:

    logging.exception(
        "Unerwarteter Fehler bei der Sprachsynthese"
    )
Durch diese Fehlerbehandlung können Probleme erkannt und protokolliert werden.
Für produktive Skripte sollte zusätzlich ein aussagekräftiger Rückgabecode verwendet werden, damit beispielsweise systemd oder ein Scheduler fehlgeschlagene Durchläufe erkennen kann.
9. Logging für automatisierte TTS-Prozesse
Wenn Sprachdateien regelmäßig und unbeaufsichtigt erzeugt werden, ist eine Protokollierung besonders wichtig.
Das Python-Modul logging bietet dafür eine einfache Möglichkeit.
Wir können die Ausgaben beispielsweise in eine Logdatei schreiben.
import logging

logging.basicConfig(
    filename="logs/piper-automation.log",
    level=logging.INFO,
    format=(
        "%(asctime)s - "
        "%(levelname)s - "
        "%(message)s"
    ),
    encoding="utf-8"
)

logging.info("Piper-Automatisierung gestartet.")

logging.warning("Eine Textdatei wurde übersprungen.")

logging.error("Fehler bei der Audioerstellung.")
Die Logdatei enthält anschließend Einträge mit Zeitstempel und Schweregrad.
Für umfangreichere Installationen empfiehlt sich eine automatische Logrotation, beispielsweise mit RotatingFileHandler oder über das Betriebssystem.
Aus Datenschutzgründen sollten vollständige Eingabetexte nicht unnötig protokolliert werden.
Stattdessen reichen häufig Dateiname, Auftrags-ID, Verarbeitungsdauer und Fehlerstatus.
10. Warteschlangen für die Sprachsynthese verwenden
Wenn mehrere Anwendungen gleichzeitig Sprachdateien erzeugen möchten, kann eine Warteschlange sinnvoll sein.
Anstatt sämtliche Texte parallel zu verarbeiten, werden die Aufträge gesammelt und kontrolliert abgearbeitet.
Python bietet dafür das Modul queue.
Für eine einfache lokale Anwendung können wir damit eine Warteschlange erstellen.
from queue import Queue
from pathlib import Path
import wave

from piper import PiperVoice

MODEL_PATH = (
    "models/de_DE-thorsten-medium.onnx"
)

voice = PiperVoice.load(MODEL_PATH)

jobs = Queue()

jobs.put({
    "text": "Erster Sprachauftrag",
    "filename": "auftrag01.wav"
})

jobs.put({
    "text": "Zweiter Sprachauftrag",
    "filename": "auftrag02.wav"
})

jobs.put({
    "text": "Dritter Sprachauftrag",
    "filename": "auftrag03.wav"
})

output_dir = Path("output")
output_dir.mkdir(exist_ok=True)

while not jobs.empty():

    job = jobs.get()

    try:

        output_file = (
            output_dir / job["filename"]
        )

        with wave.open(
            str(output_file),
            "wb"
        ) as wav_file:

            voice.synthesize_wav(
                job["text"],
                wav_file
            )

        print(
            f"Auftrag abgeschlossen: {job['filename']}"
        )

    except Exception as error:

        print(
            f"Auftrag fehlgeschlagen: {error}"
        )

    finally:

        jobs.task_done()
In diesem Beispiel werden drei Aufträge nacheinander abgearbeitet.
Die Warteschlange sorgt für eine geordnete Verarbeitung.
Allerdings handelt es sich hierbei um eine einfache In-Memory-Warteschlange. Beim Beenden des Programms gehen noch nicht abgearbeitete Aufträge verloren.
Für dauerhaft laufende Systeme sollten deshalb persistente Warteschlangen verwendet werden.
Geeignete Lösungen sind beispielsweise Redis in Kombination mit RQ oder Celery.
Auch eine SQLite-Datenbank kann für kleinere Anwendungen als persistenter Auftragsspeicher dienen.
11. WAV-Dateien automatisch in MP3 umwandeln
Piper erzeugt in unseren Beispielen WAV-Dateien.
Für die Veröffentlichung im Internet oder die Nutzung als Podcast ist MP3 häufig praktischer.
Mit FFmpeg können wir die Konvertierung automatisieren.
Zunächst ein einfacher Kommandozeilenaufruf:
ffmpeg \
  -i output/artikel.wav \
  -codec:a libmp3lame \
  -b:a 128k \
  output/artikel.mp3
Python kann diesen Vorgang direkt starten.
import subprocess
from pathlib import Path

input_file = Path("output/artikel.wav")
output_file = Path("output/artikel.mp3")

subprocess.run(
    [
        "ffmpeg",
        "-y",
        "-i",
        str(input_file),
        "-codec:a",
        "libmp3lame",
        "-b:a",
        "128k",
        str(output_file)
    ],
    check=True,
    timeout=300
)

print("MP3-Datei erfolgreich erstellt.")
Die Option check=True sorgt dafür, dass Python bei einem fehlgeschlagenen FFmpeg-Aufruf eine Ausnahme auslöst.
Der Timeout verhindert, dass der Prozess unbegrenzt wartet.
Für größere Audiodateien muss dieser Wert gegebenenfalls angepasst werden.
Alternativ können die erzeugten Audiodaten auch in Opus oder andere Formate konvertiert werden.
12. Automatische Audioverarbeitung über eine REST-API
Im vorherigen Teil unserer Serie haben wir eine eigene Piper-REST-API entwickelt.
Diese lässt sich ebenfalls aus Python automatisiert ansprechen.
Der Vorteil besteht darin, dass das Python-Skript nicht auf demselben Server wie Piper ausgeführt werden muss.
Wir erstellen dafür folgendes Beispiel:
import os
from pathlib import Path
import requests

API_URL = "https://tts.example.com/tts"

API_KEY = os.environ["PIPER_API_KEY"]

INPUT_DIR = Path("input")
OUTPUT_DIR = Path("output")

OUTPUT_DIR.mkdir(
    parents=True,
    exist_ok=True
)

for input_file in INPUT_DIR.glob("*.txt"):

    text = input_file.read_text(
        encoding="utf-8"
    ).strip()

    if not text:
        continue

    response = requests.post(
        API_URL,
        headers={
            "X-API-Key": API_KEY
        },
        json={
            "text": text
        },
        timeout=120
    )

    response.raise_for_status()

    output_file = (
        OUTPUT_DIR / f"{input_file.stem}.wav"
    )

    output_file.write_bytes(
        response.content
    )

    print(f"Erstellt: {output_file}")
Das Skript durchsucht ein Eingabeverzeichnis und übermittelt die enthaltenen Texte an den zentralen Sprachdienst.
Die Audiodateien werden anschließend lokal gespeichert.
Dadurch können auch entfernte Server, Webanwendungen oder andere Automatisierungssysteme Piper nutzen, ohne selbst ein Sprachmodell laden zu müssen.
13. Ein vollständiger automatisierter TTS-Workflow
Nachdem wir die einzelnen Funktionen kennengelernt haben, kombinieren wir sie zu einem größeren Workflow.
Unser Ziel ist eine Anwendung, die:
- Textdateien aus einem Eingabeverzeichnis einliest.
- Die Inhalte überprüft.
- Sprachdateien mit Piper erzeugt.
- WAV-Dateien automatisch in MP3 konvertiert.
- Erfolgreich verarbeitete Texte archiviert.
- Fehlerhafte Aufträge in ein separates Verzeichnis verschiebt.
- Sämtliche Verarbeitungsschritte protokolliert.
Dazu erstellen wir die Datei:
nano scripts/tts_workflow.py
from pathlib import Path
import logging
import shutil
import subprocess
import wave
import sys

from piper import PiperVoice

BASE_DIR = Path(__file__).resolve().parent.parent

INPUT_DIR = BASE_DIR / "input"
OUTPUT_DIR = BASE_DIR / "output"
ARCHIVE_DIR = BASE_DIR / "archive"
FAILED_DIR = BASE_DIR / "failed"
LOG_DIR = BASE_DIR / "logs"

MODEL_PATH = (
    BASE_DIR
    / "models"
    / "de_DE-thorsten-medium.onnx"
)

for directory in [
    INPUT_DIR,
    OUTPUT_DIR,
    ARCHIVE_DIR,
    FAILED_DIR,
    LOG_DIR
]:
    directory.mkdir(
        parents=True,
        exist_ok=True
    )

logging.basicConfig(
    filename=LOG_DIR / "workflow.log",
    level=logging.INFO,
    format="%(asctime)s %(levelname)s %(message)s",
    encoding="utf-8"
)

try:
    voice = PiperVoice.load(str(MODEL_PATH))
except Exception:
    logging.exception("Sprachmodell konnte nicht geladen werden.")
    sys.exit(1)


def convert_to_mp3(wav_file, mp3_file):

    subprocess.run(
        [
            "ffmpeg",
            "-y",
            "-loglevel",
            "error",
            "-i",
            str(wav_file),
            "-codec:a",
            "libmp3lame",
            "-b:a",
            "128k",
            str(mp3_file)
        ],
        check=True,
        timeout=600
    )


def process_file(input_file):

    wav_file = OUTPUT_DIR / f"{input_file.stem}.wav"
    mp3_file = OUTPUT_DIR / f"{input_file.stem}.mp3"

    try:

        text = input_file.read_text(
            encoding="utf-8"
        ).strip()

        if not text:
            raise ValueError(
                "Textdatei ist leer."
            )

        with wave.open(
            str(wav_file),
            "wb"
        ) as audio:

            voice.synthesize_wav(
                text,
                audio
            )

        convert_to_mp3(
            wav_file,
            mp3_file
        )

        shutil.move(
            str(input_file),
            str(ARCHIVE_DIR / input_file.name)
        )

        logging.info(
            "Erfolgreich verarbeitet: %s",
            input_file.name
        )

    except Exception:

        logging.exception(
            "Verarbeitung fehlgeschlagen: %s",
            input_file.name
        )

        shutil.move(
            str(input_file),
            str(FAILED_DIR / input_file.name)
        )


def main():

    files = sorted(INPUT_DIR.glob("*.txt"))

    logging.info(
        "Workflow gestartet. Aufträge: %s",
        len(files)
    )

    for input_file in files:
        process_file(input_file)

    logging.info("Workflow abgeschlossen.")


if __name__ == "__main__":
    main()
Dieses Beispiel zeigt, wie sich verschiedene Funktionen zu einer automatisierten Verarbeitungskette verbinden lassen.
Für einen ersten lokalen Test ist die Lösung bereits gut geeignet.
Für einen produktiven Betrieb sollten wir allerdings noch einige Punkte verbessern.
Dazu gehören eindeutige Auftragskennungen, die Vermeidung von Dateinamenskollisionen, atomare Dateiverschiebungen, Wiederholungsversuche bei vorübergehenden Fehlern und eine Bereinigung unvollständiger Ausgabedateien.
Auch sollte eine Datei erst dann als erfolgreich verarbeitet gelten, wenn sämtliche Ausgabedateien vollständig geschrieben und überprüft wurden.
14. Automatisierung mit Cron und systemd
Unser Python-Workflow kann manuell gestartet werden.
Für eine regelmäßige Ausführung lässt er sich jedoch auch über das Betriebssystem automatisieren.
Ein einfaches Beispiel ist Cron.
Wir öffnen die Crontab:
crontab -e
Anschließend ergänzen wir beispielsweise:
*/10 * * * * /home/USER/piper-automation/venv/bin/python /home/USER/piper-automation/scripts/tts_workflow.py
Damit wird das Skript alle zehn Minuten gestartet.
USER muss durch den tatsächlichen Linux-Benutzernamen ersetzt werden.
Bei regelmäßig laufenden Jobs sollte verhindert werden, dass mehrere Instanzen gleichzeitig dieselben Dateien verarbeiten.
Dafür kann beispielsweise flock verwendet werden.
*/10 * * * * /usr/bin/flock -n /tmp/piper-workflow.lock /home/USER/piper-automation/venv/bin/python /home/USER/piper-automation/scripts/tts_workflow.py
Alternativ kann ein systemd-Timer verwendet werden.
Dieser bietet zusätzliche Möglichkeiten zur Überwachung und Steuerung.
Die Einrichtung von systemd-Diensten und Timern behandeln wir ausführlicher im nächsten Teil unserer Serie.
15. Praxisbeispiel: Blogartikel automatisch vertonen
Eine besonders interessante Anwendung ist die automatische Erstellung von Hörfassungen für Blogartikel.
Der Ablauf könnte folgendermaßen aussehen:
Ein neuer Artikel wird veröffentlicht und als Textdatei oder über eine Schnittstelle bereitgestellt.
Ein Python-Skript übernimmt den Artikeltext, entfernt gegebenenfalls HTML-Elemente und bereitet den Inhalt für die Sprachausgabe auf.
Anschließend wird der Text an Piper übergeben.
Die erzeugte WAV-Datei wird in MP3 konvertiert und unter einem passenden Dateinamen gespeichert.
Abschließend kann die Audiodatei über einen Audioplayer im Blog eingebunden werden.
Für einen IT-Blog bietet das mehrere Vorteile.
Leser können längere technische Beiträge auch unterwegs anhören. Gleichzeitig lassen sich Inhalte barriereärmer bereitstellen, wobei eine automatische Hörfassung allein noch keine vollständige Barrierefreiheit gewährleistet.
Besonders wichtig ist die Aufbereitung technischer Inhalte.
Befehle, Dateipfade, Tabellen, Aufzählungen und englische Fachbegriffe sollten vor der Sprachsynthese angepasst werden.
Ein Linux-Befehl wie:
sudo apt update
sollte in einer Hörfassung beispielsweise nicht einfach Zeichen für Zeichen vorgelesen werden.
Stattdessen kann der Text lauten:
„Aktualisieren Sie zunächst die Paketinformationen mit dem Befehl sudo apt update.“
Auch URLs, Versionsnummern und Abkürzungen benötigen häufig eine spezielle Behandlung.
Diese Textvorverarbeitung kann ebenfalls mit Python automatisiert werden.
16. Performance bei größeren Textmengen optimieren
Bei der automatisierten Verarbeitung zahlreicher Texte spielt die Performance eine wichtige Rolle.
Die wichtigste Grundregel lautet: Das Sprachmodell sollte möglichst nicht für jede einzelne Datei neu geladen werden.
Das Laden eines Modells benötigt Zeit und Arbeitsspeicher.
Bei einer Batch-Verarbeitung ist es deshalb effizienter, Piper einmal zu initialisieren und anschließend mehrere Texte nacheinander zu verarbeiten.
Weitere Optimierungsmöglichkeiten sind die Aufteilung langer Texte in kleinere Abschnitte, das Zwischenspeichern bereits erzeugter Audiodateien und die kontrollierte Parallelverarbeitung.
Eine unbegrenzte Anzahl paralleler Syntheseprozesse ist dagegen nicht empfehlenswert.
Sie kann zu hoher CPU-Auslastung, erhöhtem Speicherverbrauch und längeren Antwortzeiten führen.
Für kleinere Installationen genügt häufig ein einzelner Worker.
Bei größeren Systemen können mehrere Prozesse eingesetzt werden, sofern ausreichend Arbeitsspeicher und Rechenleistung zur Verfügung stehen.
Jeder Prozess benötigt dabei gegebenenfalls eine eigene Modellinstanz.
Auch eine Kombination aus Warteschlange, mehreren Workern und zentralem Dateispeicher ist möglich.
17. Sicherheit und Datenschutz bei automatisierten Workflows
Automatisierte TTS-Systeme können Texte aus unterschiedlichen Quellen verarbeiten.
Dazu gehören möglicherweise auch personenbezogene oder vertrauliche Informationen.
Deshalb sollten bereits bei der Entwicklung geeignete Sicherheitsmaßnahmen berücksichtigt werden.
Die Eingabeverzeichnisse dürfen nur für berechtigte Benutzer und Prozesse zugänglich sein.
API-Schlüssel und Zugangsdaten sollten nicht im Quellcode gespeichert werden.
Außerdem ist darauf zu achten, dass Protokolldateien keine unnötigen vertraulichen Inhalte enthalten.
Für temporäre Audiodateien empfiehlt sich eine definierte Aufbewahrungsdauer.
Nicht mehr benötigte Dateien sollten automatisch gelöscht werden.
Bei der Verarbeitung externer Texte ist außerdem eine Eingabevalidierung sinnvoll.
Dateinamen dürfen nicht ungeprüft aus Benutzereingaben übernommen werden, da sonst unerwünschte Dateipfade entstehen können.
Externe Programme wie FFmpeg sollten über sichere Python-Schnittstellen aufgerufen werden, ohne unkontrollierte Shell-Befehle zusammenzusetzen.
In Unternehmen und Behörden sollten solche Automatisierungen zusätzlich in vorhandene Sicherheits-, Berechtigungs- und Datenschutzkonzepte eingebunden werden.
18. Erweiterungsmöglichkeiten für professionelle TTS-Systeme
Unsere bisherige Lösung kann bereits zahlreiche Aufgaben automatisiert erledigen.
Für größere Installationen bieten sich jedoch zusätzliche Funktionen an.
Eine Möglichkeit ist die Verwaltung von Aufträgen über eine Datenbank.
Jeder Auftrag erhält dabei eine eindeutige Kennung und einen Status wie „wartend“, „in Bearbeitung“, „abgeschlossen“ oder „fehlgeschlagen“.
Darüber hinaus können Wiederholungsversuche implementiert werden.
Schlägt eine Verarbeitung aufgrund eines vorübergehenden Problems fehl, wird der Auftrag nach einer definierten Wartezeit erneut gestartet.
Auch Benachrichtigungen lassen sich integrieren.
Beispielsweise kann das System nach erfolgreicher Verarbeitung eine E-Mail versenden oder einen Webhook aufrufen.
Für umfangreiche Audio-Workflows ist außerdem eine zentrale Verwaltung der erzeugten Dateien sinnvoll.
Die Audiodateien könnten beispielsweise auf einem NAS, einem zentralen Dateiserver oder einem S3-kompatiblen Objektspeicher abgelegt werden.
In Verbindung mit einer REST-API entsteht daraus eine flexible Plattform für die automatisierte Sprachsynthese.
Python macht Piper TTS zu einem vielseitig automatisierbaren Werkzeug für die lokale Sprachsynthese.
Bereits mit wenigen Zeilen Code lassen sich Texte in WAV-Dateien umwandeln, ganze Verzeichnisse verarbeiten und Audiodateien automatisch organisieren.
Durch zusätzliche Funktionen wie Logging, Fehlerbehandlung, Warteschlangen, MP3-Konvertierung und zeitgesteuerte Ausführung entstehen daraus leistungsfähige Audio-Workflows.
Besonders interessant ist die Kombination mit einem zentralen Piper-API-Dienst. Dadurch können auch entfernte Anwendungen Sprachdateien erzeugen lassen, ohne selbst ein Sprachmodell installieren zu müssen.
Für produktive Installationen empfiehlt sich eine klare Trennung zwischen Eingabedaten, Verarbeitung, Ausgabedateien und Archivierung. Ergänzt um Monitoring, Zugriffskontrollen und eine zuverlässige Auftragsverwaltung lässt sich Piper auch für größere Automatisierungsaufgaben einsetzen.
Der größte Vorteil bleibt dabei die lokale Verarbeitung: Texte können vollständig innerhalb der eigenen Infrastruktur in Sprache umgewandelt werden, ohne auf einen externen Cloud-TTS-Dienst angewiesen zu sein.