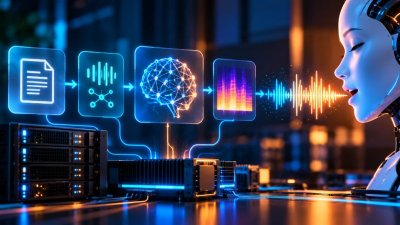
Künstliche Intelligenz kann Texte schreiben, Fragen beantworten, Dokumente analysieren und komplexe Aufgaben lösen. Doch was passiert, wenn eine KI ihre Antworten nicht nur auf einem Bildschirm anzeigen, sondern auch sprechen soll? Genau hier kommt Piper TTS ins Spiel.
Piper ist eine leistungsfähige Open-Source-Lösung zur lokalen Sprachsynthese. Die Software wandelt geschriebene Texte in gesprochene Sprache um – ohne dass dafür zwingend eine Cloud-Verbindung, ein kostenpflichtiger Onlinedienst oder eine leistungsfähige Grafikkarte erforderlich ist.
Besonders interessant ist Piper für Betreiber eigener Linux-Server, Homelab-Enthusiasten, Unternehmen und Organisationen, die ihre Daten möglichst vollständig unter eigener Kontrolle behalten möchten.
In diesem ersten Teil unserer Blogserie beschäftigen wir uns mit den Grundlagen von Piper TTS. Wir erklären, wie die Technologie funktioniert, welche Vorteile sie bietet, wo ihre Grenzen liegen und warum Piper eine interessante Ergänzung für lokale KI-Systeme wie Ollama und Open WebUI ist.
Was ist Piper TTS?
Piper TTS ist eine lokale Text-to-Speech-Engine (TTS). Ihre Aufgabe besteht darin, geschriebenen Text automatisch in gesprochene Sprache umzuwandeln.
Die Software verwendet neuronale Sprachmodelle, um aus einem Text eine Audiodatei mit einer synthetischen Stimme zu erzeugen.
Ein einfaches Beispiel:
Ein Benutzer gibt folgenden Text ein:
Willkommen bei open-how2.de. In diesem Artikel beschäftigen wir uns mit lokaler Sprachsynthese und künstlicher Intelligenz.
Piper verarbeitet den Text und erzeugt daraus eine Audiodatei, die beispielsweise über einen Lautsprecher oder einen Audioplayer abgespielt werden kann.
Anders als viele kommerzielle Text-to-Speech-Angebote benötigt Piper für die eigentliche Sprachgenerierung keine Verbindung zu einem externen Cloud-Dienst.
Sobald die Software und die benötigten Sprachmodelle installiert sind, kann die Verarbeitung vollständig lokal erfolgen.
Piper wurde ursprünglich von Michael Hansen entwickelt und ist eng mit dem Open-Source-Umfeld rund um lokale Sprachassistenten verbunden. Die Weiterentwicklung erfolgt inzwischen im Umfeld von OHF-Voice. Deshalb sollte bei neuen Installationen auf die jeweils aktuell gepflegten Projekte und Dokumentationen geachtet werden.
Ein wesentlicher Vorteil besteht darin, dass Piper auch auf vergleichsweise leistungsschwacher Hardware betrieben werden kann.
Was bedeutet Text-to-Speech?
Text-to-Speech bezeichnet ein Verfahren, bei dem geschriebene Sprache automatisch in hörbare Sprache umgewandelt wird.
Die Technologie ist keineswegs neu. Bereits seit Jahrzehnten existieren Programme, die Texte vorlesen können.
Frühere Systeme verwendeten häufig regelbasierte Verfahren oder setzten Sprache aus einzelnen aufgezeichneten Bestandteilen zusammen.
Die Ergebnisse klangen oft mechanisch, monoton und wenig natürlich.
Moderne TTS-Systeme verwenden dagegen künstliche neuronale Netze.
Diese Modelle lernen aus Sprachaufnahmen, wie Wörter ausgesprochen werden, wie sich Sprachlaute zusammensetzen und welche akustischen Eigenschaften eine menschliche Stimme besitzt.
Dadurch lassen sich deutlich natürlichere Sprachausgaben erzeugen.
Moderne Sprachsynthese berücksichtigt unter anderem:
- Aussprache einzelner Wörter
- Betonung innerhalb eines Satzes
- Sprachrhythmus und Sprechgeschwindigkeit
- Übergänge zwischen Sprachlauten
- Pausen zwischen Sätzen
- Klangfarbe und Charakteristik einer Stimme
Allerdings hängt die tatsächliche Qualität stark vom verwendeten Sprachmodell ab.
Nicht jedes Modell klingt gleichermaßen natürlich. Auch die Aussprache von Abkürzungen, Zahlen oder technischen Fachbegriffen kann unterschiedlich gut funktionieren.
Wie funktioniert die neuronale Sprachsynthese mit Piper?
Damit aus einem geschriebenen Satz eine Audiodatei entsteht, sind mehrere Verarbeitungsschritte erforderlich.
1. Text wird entgegengenommen
Zunächst erhält Piper einen Text.
Dieser kann beispielsweise aus einer Datei, einem Python-Skript, einer Webanwendung oder der Antwort eines KI-Sprachmodells stammen.
Piper selbst erzeugt dabei keine inhaltlichen Antworten. Die Software ist ausschließlich für die Umwandlung von Text in Sprache zuständig.
2. Text wird sprachlich vorbereitet
Bevor die eigentliche Sprachsynthese beginnt, muss der Text in eine geeignete Darstellung überführt werden.
Hierbei spielen insbesondere die Aussprache und die Zerlegung von Wörtern in Sprachlaute eine wichtige Rolle.
Diesen Vorgang bezeichnet man als Phonemisierung.
Ein Phonem ist eine grundlegende lautliche Einheit einer Sprache.
Bei Piper wird hierfür typischerweise eine entsprechende Phonemisierungskomponente verwendet, beispielsweise auf Grundlage von eSpeak NG.
Die Qualität der sprachlichen Vorbereitung beeinflusst unmittelbar die spätere Aussprache.
3. Das neuronale Sprachmodell verarbeitet die Eingabe
Die vorbereiteten Sprachinformationen werden anschließend an das neuronale Modell übergeben.
Piper verwendet hierfür Modelle, die für eine effiziente lokale Sprachsynthese optimiert sind.
Die verfügbaren Modelle basieren typischerweise auf VITS-ähnlichen Architekturen und werden häufig im ONNX-Format bereitgestellt.
ONNX steht für Open Neural Network Exchange.
Das Format ermöglicht es, trainierte neuronale Modelle mit geeigneten Laufzeitumgebungen auszuführen, ohne dass dafür zwingend die ursprüngliche Trainingsumgebung benötigt wird.
4. Die Audiodaten werden erzeugt
Das Modell berechnet aus der Eingabe eine digitale Darstellung der gesprochenen Sprache.
Bei Piper entsteht daraus ein Audiosignal, das anschließend beispielsweise als WAV-Datei gespeichert werden kann.
5. Die Sprache wird wiedergegeben
Die fertige Audiodatei kann nun abgespielt, heruntergeladen, weiterverarbeitet oder in andere Anwendungen integriert werden.
Der gesamte Ablauf lässt sich vereinfacht folgendermaßen darstellen:
- Texteingabe
- Benutzer, Anwendung oder KI-Sprachmodell
- Textverarbeitung und Phonemisierung
- Vorbereitung der Aussprache
- Neuronales Piper-Sprachmodell
- Berechnung der Sprachausgabe mit ONNX Runtime
- Audiodaten
- Digital erzeugtes Sprachsignal
- Sprachausgabe
- WAV-Datei, Audioplayer oder Lautsprecher
Piper TTS ist Open Source
Ein wichtiger Aspekt von Piper ist die offene Entwicklung.
Der Quellcode kann eingesehen, geprüft und entsprechend den jeweiligen Lizenzbedingungen verwendet oder angepasst werden.
Das unterscheidet Piper von zahlreichen proprietären Sprachdiensten, bei denen die eigentliche Sprachgenerierung ausschließlich auf den Servern des jeweiligen Anbieters stattfindet.
Open Source bietet insbesondere folgende Vorteile.
Transparenz
Administratoren und Entwickler können nachvollziehen, welche Softwarekomponenten verwendet werden und wie die Verarbeitung grundsätzlich funktioniert.
Unabhängigkeit
Der Betrieb ist nicht unmittelbar von der dauerhaften Verfügbarkeit eines kommerziellen Cloud-Dienstes abhängig.
Anpassbarkeit
Piper kann in eigene Anwendungen integriert und mit anderen Open-Source-Komponenten kombiniert werden.
Selbsthosting
Die Software kann auf eigener Hardware betrieben werden. Dadurch lassen sich Betrieb, Updates, Zugriffsmöglichkeiten und Datenverarbeitung selbst steuern.
Allerdings bedeutet Open Source nicht automatisch, dass sämtliche Sprachmodelle ohne Einschränkungen verwendet werden dürfen.
Die Lizenz des Programmcodes und die Nutzungsbedingungen einzelner Sprachmodelle müssen getrennt betrachtet werden. Das ist besonders wichtig, wenn Piper in kommerziellen Anwendungen oder öffentlich zugänglichen Diensten eingesetzt werden soll.
Lokale Sprachsynthese statt Cloud-TTS
Viele bekannte Sprachsynthesedienste werden über das Internet bereitgestellt.
Der typische Ablauf sieht folgendermaßen aus:
Ein Benutzer übermittelt einen Text an einen Cloud-Dienst. Dort wird der Text verarbeitet und anschließend eine Audiodatei zurückgegeben.
Das funktioniert komfortabel, bringt jedoch bestimmte Abhängigkeiten mit sich.
Bei Piper kann die Verarbeitung dagegen vollständig innerhalb der eigenen IT-Infrastruktur erfolgen.
Das bietet mehrere Vorteile.
Keine Übertragung an externe TTS-Anbieter erforderlich
Texte müssen für die Sprachgenerierung nicht an einen externen Anbieter gesendet werden.
Dies ist besonders interessant, wenn interne Dokumente, vertrauliche Informationen oder personenbezogene Daten vorgelesen werden sollen.
Keine nutzungsabhängigen Cloud-TTS-Gebühren
Für die lokale Sprachgenerierung fallen keine nutzungsabhängigen API-Gebühren eines externen TTS-Anbieters an.
Natürlich entstehen weiterhin Kosten für Hardware, Strom, Administration und gegebenenfalls die Integration.
Unabhängigkeit von der Internetverbindung
Ist Piper vollständig eingerichtet, kann die Sprachgenerierung auch ohne Internetzugang erfolgen.
Kontrolle über die Infrastruktur
Administratoren entscheiden selbst, auf welchen Systemen die Software läuft, wer darauf zugreifen darf und wie die erzeugten Audiodaten gespeichert werden.
Datenschutz und DSGVO
Gerade in Unternehmen und Behörden kann lokale Sprachsynthese einen wichtigen Beitrag zu einer datenschutzfreundlichen IT-Architektur leisten.
Werden Texte an externe Sprachdienste übertragen, muss unter anderem geprüft werden, welche Daten verarbeitet werden, wo die Verarbeitung stattfindet und welche vertraglichen oder datenschutzrechtlichen Anforderungen bestehen.
Bei Piper lässt sich die Sprachgenerierung auf eigenen Servern durchführen.
Dadurch kann die Übermittlung von Texten an externe TTS-Dienstleister vermieden werden.
Das bedeutet jedoch nicht, dass eine Piper-Installation automatisch DSGVO-konform ist.
Auch bei einer lokalen Installation müssen beispielsweise folgende Punkte berücksichtigt werden:
- Zugriffsschutz für den TTS-Dienst
- Berechtigungen für Benutzer und Anwendungen
- Schutz der übermittelten Texte
- Speicherung und Löschung erzeugter Audiodateien
- Protokollierung und Aufbewahrungsfristen
- Verschlüsselung bei Netzwerkzugriffen
- Absicherung des Betriebssystems und der Schnittstellen
Wird Piper über eine REST-API bereitgestellt, sollten insbesondere Authentifizierung, Netzwerksegmentierung und verschlüsselte Verbindungen berücksichtigt werden.
Für Behörden und andere Organisationen mit erhöhten Sicherheitsanforderungen kann eine vollständig lokale TTS-Lösung daher eine interessante Architekturentscheidung sein.
Piper TTS vollständig offline betreiben
Ein besonderer Vorteil von Piper ist die Möglichkeit des Offline-Betriebs.
Für die eigentliche Sprachgenerierung benötigt Piper keine permanente Verbindung zum Internet.
Voraussetzung ist allerdings, dass sämtliche benötigten Komponenten bereits vorhanden sind.
Dazu gehören insbesondere die ausführbare Software, ihre Abhängigkeiten und das gewünschte Sprachmodell.
Ein typisches Offline-System könnte beispielsweise aus einem Debian- oder Ubuntu-Server bestehen, auf dem Piper installiert wurde.
Ein Benutzer übermittelt einen Text über eine interne Anwendung. Piper erzeugt die Audiodatei und stellt sie anschließend innerhalb des lokalen Netzwerks bereit.
Eine Internetverbindung ist dafür nicht erforderlich.
Diese Architektur eignet sich unter anderem für abgeschottete Netze, interne Assistenzsysteme, technische Labore und Umgebungen, in denen externe Cloud-Dienste nicht erwünscht sind.
Wichtig ist allerdings, dass der Offline-Betrieb nicht automatisch eine sichere Installation garantiert. Updates, Zugriffsrechte und die Vertrauenswürdigkeit der verwendeten Softwarepakete müssen weiterhin berücksichtigt werden.
Welche Hardware benötigt Piper TTS?
Piper wurde mit dem Ziel entwickelt, Sprachsynthese auch auf vergleichsweise ressourcenschwacher Hardware zu ermöglichen.
Im Gegensatz zu großen generativen KI-Modellen ist für viele Piper-Anwendungen keine besonders leistungsfähige Hardware erforderlich.
Betrieb auf der CPU
Piper kann vollständig auf einem normalen Prozessor betrieben werden.
Für die Erstellung einzelner Sprachdateien oder die Sprachausgabe eines lokalen Assistenten reicht häufig bereits ein moderner Mehrkernprozessor aus.
Auch kleine Systeme wie Mini-PCs oder geeignete Einplatinencomputer kommen grundsätzlich infrage.
Die tatsächliche Geschwindigkeit hängt unter anderem vom verwendeten Sprachmodell, der Prozessorleistung und der Textlänge ab.
Betrieb mit GPU
Die ONNX Runtime unterstützt grundsätzlich unterschiedliche Ausführungsumgebungen, darunter auch GPU-basierte Verfahren.
Ob Piper tatsächlich GPU-Beschleunigung nutzen kann, hängt jedoch von der eingesetzten Piper-Version, den installierten Laufzeitbibliotheken und dem jeweiligen Ausführungsanbieter ab.
GPU-Unterstützung sollte daher nicht pauschal vorausgesetzt werden.
Für viele typische Piper-Anwendungen ist sie auch nicht erforderlich.
Interessant kann GPU-Beschleunigung insbesondere dann werden, wenn viele Texte parallel verarbeitet oder größere Mengen an Audiodaten erzeugt werden sollen.
Arbeitsspeicher
Der benötigte Arbeitsspeicher hängt vor allem vom verwendeten Sprachmodell und der Anzahl gleichzeitig laufender Instanzen ab.
Kleinere Sprachmodelle benötigen weniger Ressourcen, während größere Modelle mehr Speicher beanspruchen können.
Bei der Planung eines produktiven Systems sollten außerdem Betriebssystem, API-Dienst und gegebenenfalls weitere KI-Komponenten berücksichtigt werden.
Piper in virtuellen Maschinen und Containern
Piper lässt sich auch in virtualisierten Umgebungen betreiben.
Typische Möglichkeiten sind:
- Virtuelle Maschinen unter Proxmox VE
- Linux-Container mit LXC oder Incus
- Docker-Container
- Dedizierte Debian- und Ubuntu-Server
Damit eignet sich Piper auch für vorhandene Homelab- und Serverinfrastrukturen.
Deutsche Sprachmodelle für Piper
Für Piper stehen Sprachmodelle in verschiedenen Sprachen zur Verfügung, darunter auch Deutsch.
Die Modelle unterscheiden sich beispielsweise hinsichtlich ihrer Klangcharakteristik, Größe und Sprachqualität.
Je nach Modell können unterschiedliche Stimmen und Qualitätsstufen verfügbar sein.
Einige Modelle sind stärker auf Geschwindigkeit und geringen Ressourcenverbrauch ausgelegt. Andere bieten eine höhere Sprachqualität, benötigen dafür jedoch möglicherweise mehr Rechenleistung.
Für deutsche Blogartikel und technische Dokumentationen sind insbesondere eine verständliche Aussprache und ein angenehmer Sprachrhythmus wichtig.
Eine besondere Herausforderung stellen technische Begriffe dar.
Beispielsweise können Wörter wie Kubernetes, Proxmox, Debian, Docker oder Open WebUI von einem Sprachmodell anders ausgesprochen werden als erwartet.
Hier kann eine gezielte Vorbereitung des Textes helfen.
Im fünften Teil unserer Serie werden wir uns deshalb ausführlich mit deutschen Piper-Stimmen beschäftigen und verschiedene Modelle miteinander vergleichen.
Piper TTS und Ollama: Wenn lokale KI sprechen lernt
Eine besonders interessante Einsatzmöglichkeit entsteht durch die Kombination von Piper mit Ollama.
Ollama ermöglicht den lokalen Betrieb großer Sprachmodelle.
Diese Modelle können Fragen beantworten, Texte erstellen oder Informationen zusammenfassen.
Allerdings erzeugt ein klassisches textbasiertes Ollama-Modell zunächst nur Text.
Piper kann diese Antworten anschließend in gesprochene Sprache umwandeln.
Die Aufgaben sind dabei klar getrennt.
Ollama ist für die Textgenerierung zuständig. Piper übernimmt die Sprachsynthese.
Ein Beispiel:
Ein Benutzer stellt einem lokalen KI-Assistenten eine Frage.
Ollama verarbeitet die Anfrage und erstellt eine Antwort.
Die Antwort wird an Piper übergeben.
Piper erzeugt daraus eine Audiodatei.
Der Benutzer kann sich die Antwort anschließend anhören.
Damit entsteht ein vollständig lokal betreibbarer KI-Assistent mit Sprachausgabe.
Besonders interessant ist diese Kombination für Systeme, bei denen sensible Informationen nicht an externe Cloud-Anbieter übertragen werden sollen.
Piper TTS und Open WebUI
Open WebUI ist eine webbasierte Benutzeroberfläche für lokale und angebundene KI-Sprachmodelle.
Die Plattform bietet Funktionen für die Interaktion mit Modellen, die Verwaltung von Chats und die Integration zusätzlicher Dienste.
Durch die Einbindung eines geeigneten TTS-Backends lassen sich KI-Antworten auch akustisch ausgeben.
Piper kann hierfür als Sprachsynthese-Engine dienen.
Da Piper nicht in jeder Installationsvariante unmittelbar eine zu Open WebUI kompatible Schnittstelle bereitstellt, kann ein zusätzlicher API-Dienst erforderlich sein.
Dieser übernimmt die Kommunikation zwischen Open WebUI und Piper.
Ein entsprechendes System kann beispielsweise aus folgenden Komponenten bestehen:
- Ollama für die lokale KI
- Open WebUI als Benutzeroberfläche
- Piper für die Sprachausgabe
- Ein API-Dienst als Schnittstelle
- Ein Browser oder Audioplayer zur Wiedergabe
Die konkrete Integration behandeln wir später in einem eigenen Artikel.
Typische Einsatzmöglichkeiten von Piper TTS
Piper lässt sich in zahlreiche Anwendungen integrieren.
1. Blogartikel automatisch vertonen
Ein besonders interessantes Einsatzgebiet ist die automatische Erstellung von Hörfassungen.
Statt einen Blogartikel ausschließlich als Text bereitzustellen, kann zusätzlich eine Audiodatei erzeugt werden.
Die Leser können den Artikel dann anhören, beispielsweise während einer Autofahrt, beim Sport oder unterwegs.
Für einen IT-Blog wie open-how2.de wäre es beispielsweise denkbar, veröffentlichte Beiträge automatisch in MP3-Dateien umzuwandeln und direkt im Artikel einen Audioplayer anzubieten.
2. Lokale KI-Assistenten
Piper kann die Antworten lokaler Sprachmodelle vorlesen.
In Verbindung mit einer Speech-to-Text-Lösung entsteht ein Sprachassistent, der sowohl gesprochene Eingaben verstehen als auch gesprochene Antworten ausgeben kann.
3. Automatische Benachrichtigungen
Piper kann dynamische Sprachmeldungen erzeugen.
Beispielsweise könnte ein Monitoring-System eine Störung erkennen und automatisch eine entsprechende Audioansage erstellen.
Auch Statusmeldungen von Servern oder automatisierten Prozessen lassen sich auf diese Weise ausgeben.
4. Smart Home
Im Smart-Home-Bereich kann Piper zur lokalen Sprachausgabe verwendet werden.
In Kombination mit Home Assistant lassen sich beispielsweise Wetterinformationen, Erinnerungen oder Statusmeldungen über Lautsprecher ausgeben.
5. Barrierefreiheit
Sprachausgabe kann dabei helfen, digitale Inhalte auch Menschen zugänglich zu machen, denen das Lesen längerer Texte schwerfällt.
Piper kann hierbei als technische Komponente in barrierearme Anwendungen integriert werden.
Allerdings ersetzt die bloße Integration einer TTS-Engine noch keine umfassende barrierefreie Gestaltung.
6. Podcasts und Audioproduktion
Piper kann Texte in Audiodateien umwandeln, die anschließend mit Programmen wie FFmpeg weiterverarbeitet werden.
Denkbar sind beispielsweise automatisch erzeugte Nachrichtenüberblicke, technische Zusammenfassungen oder gesprochene Dokumentationen.
Für anspruchsvolle Podcast-Produktionen müssen allerdings die Grenzen hinsichtlich Natürlichkeit, Emotion und Sprachgestaltung berücksichtigt werden.
7. Unternehmen und Behörden
Auch in Organisationen kann Piper sinnvoll eingesetzt werden.
Mögliche Anwendungen sind interne Informationssysteme, die Vertonung von Schulungsunterlagen, automatisierte Ansagen oder lokal betriebene KI-Assistenten.
Insbesondere bei vertraulichen Inhalten kann die lokale Verarbeitung ein wichtiger Vorteil sein.
Welche Stärken besitzt Piper TTS?
Piper bietet mehrere Eigenschaften, die die Software für den lokalen Einsatz attraktiv machen.
Geringe Hardwareanforderungen: Für viele Aufgaben reicht eine normale CPU aus.
Lokale Verarbeitung: Texte müssen für die Sprachgenerierung nicht an externe Dienste übertragen werden.
Offline-Fähigkeit: Nach vollständiger Einrichtung ist keine dauerhafte Internetverbindung erforderlich.
Open Source: Die Software kann im Rahmen ihrer Lizenzbedingungen selbst betrieben und angepasst werden.
Automatisierbarkeit: Piper lässt sich über Skripte, Programme und geeignete Schnittstellen in bestehende Abläufe integrieren.
Mehrsprachigkeit: Es stehen Sprachmodelle für unterschiedliche Sprachen zur Verfügung.
Gute Integration in Linux-Umgebungen: Piper eignet sich für Server, Container und automatisierte Workflows.
Gerade die Kombination aus lokalem Betrieb, vergleichsweise geringem Ressourcenbedarf und Automatisierbarkeit macht Piper für Self-Hosting besonders interessant.
Wo liegen die Grenzen von Piper TTS?
Trotz seiner Vorteile ist Piper nicht für jede Anwendung die optimale Lösung.
Sprachqualität
Die Qualität hängt stark vom verwendeten Modell ab.
Während manche Stimmen angenehm und gut verständlich klingen, können andere noch deutlich synthetisch wirken.
Emotionale Ausdrucksmöglichkeiten
Piper ist in erster Linie auf effiziente Sprachsynthese ausgelegt.
Eine fein abgestimmte emotionale Gestaltung, beispielsweise besonders dramatisches, fröhliches oder flüsterndes Sprechen, ist nicht bei allen Modellen möglich.
Aussprache technischer Begriffe
Abkürzungen, Produktnamen, fremdsprachige Begriffe und ungewöhnliche Schreibweisen können falsch ausgesprochen werden.
Hier ist unter Umständen eine Textvorverarbeitung notwendig.
Stimmenauswahl
Die Auswahl verfügbarer Stimmen ist abhängig von Sprache, Modellbestand und Lizenzbedingungen.
Nicht für jede Sprache existiert eine gleichermaßen große Auswahl hochwertiger Stimmen.
Keine integrierte Texterzeugung
Piper ist kein Large Language Model.
Die Software kann keine Fragen beantworten, Texte recherchieren oder eigenständig Inhalte erstellen.
Für solche Aufgaben wird eine zusätzliche Anwendung benötigt.
Zusätzliche Infrastruktur bei Webanwendungen
Soll Piper über eine Weboberfläche oder mehrere Anwendungen hinweg genutzt werden, sind häufig zusätzliche Komponenten erforderlich.
Dazu können API-Dienste, Warteschlangen, Authentifizierung und Caching gehören.
Piper TTS gegenüber kommerziellen Cloud-Diensten
Kommerzielle TTS-Plattformen bieten häufig eine große Auswahl professioneller Stimmen, umfangreiche APIs und zusätzliche Möglichkeiten zur Steuerung von Aussprache und Emotion.
Piper verfolgt einen anderen Ansatz.
Im Mittelpunkt stehen lokale Ausführung, Effizienz, Unabhängigkeit und die Möglichkeit, Sprachsynthese in selbst betriebene Anwendungen zu integrieren.
Wer besonders ausdrucksstarke Stimmen für professionelle Hörbücher oder aufwendig produzierte Werbespots benötigt, findet bei spezialisierten kommerziellen Diensten möglicherweise passendere Angebote.
Wer dagegen einen zuverlässigen, lokal betreibbaren Sprachdienst für Automatisierungen, KI-Assistenten oder technische Anwendungen sucht, sollte Piper genauer betrachten.
Die Entscheidung hängt deshalb weniger davon ab, welche Lösung grundsätzlich besser ist, sondern davon, welche Anforderungen erfüllt werden müssen.
Für wen eignet sich Piper TTS besonders?
Piper ist vor allem für Anwender interessant, die ihre Systeme selbst betreiben und möglichst unabhängig von externen Diensten bleiben möchten.
Dazu gehören beispielsweise Administratoren, Entwickler, Homelab-Betreiber und Betreiber eigener KI-Infrastrukturen.
Auch für Unternehmen und öffentliche Verwaltungen kann Piper eine interessante Ergänzung bestehender Anwendungen sein.
Besonders sinnvoll ist der Einsatz, wenn regelmäßig Texte automatisiert vorgelesen werden sollen, eine lokale KI bereits vorhanden ist oder vertrauliche Informationen nicht an einen externen TTS-Anbieter übertragen werden sollen.
Wer dagegen eine sofort einsatzbereite Komplettlösung mit professioneller Sprecherregie und besonders umfangreicher Stimmenauswahl benötigt, muss prüfen, ob Piper die eigenen Qualitätsanforderungen erfüllt.
Piper macht lokale KI hörbar
Piper TTS zeigt, dass moderne Sprachsynthese nicht zwangsläufig einen Cloud-Dienst oder teure Spezialhardware benötigt.
Mit einer vergleichsweise schlanken Open-Source-Lösung lassen sich Texte direkt auf eigenen Systemen in Sprache umwandeln.
Besonders interessant ist dabei die Kombination mit anderen lokalen KI-Komponenten.
Ollama erzeugt die Inhalte, Open WebUI stellt die Benutzeroberfläche bereit und Piper sorgt dafür, dass die KI ihre Antworten auch sprechen kann.
Damit eröffnet Piper zahlreiche Möglichkeiten – von einfachen Sprachmeldungen über automatisierte Hörfassungen bis hin zu vollständig lokalen Sprachassistenten.
Natürlich gibt es Grenzen. Nicht jede Stimme klingt vollkommen natürlich, technische Begriffe können Probleme bereiten und für komplexere Anwendungen sind zusätzliche Schnittstellen erforderlich.
Dennoch ist Piper eine überzeugende Grundlage für alle, die Sprachsynthese unter eigener Kontrolle betreiben möchten.
Im nächsten Teil unserer Blogserie – „Architektur und Funktionsweise von Piper TTS“ – schauen wir genauer unter die Haube. Wir beschäftigen uns mit neuronalen Sprachmodellen, Phonemisierung, ONNX Runtime, Audioerzeugung und den technischen Komponenten, die aus geschriebenem Text gesprochene Sprache machen.
Denn eine KI, die schreiben kann, ist praktisch. Eine KI, die zusätzlich sprechen kann, eröffnet völlig neue Möglichkeiten.